Die Cloud-Rechnung musste weg
Proof of concepts sind günstig. Produktion nicht. Entdecken Sie, warum ein Post-Production-Team steigende Token-Rechnungen durch einen Vier-GPU-Rack-Server ersetzte, der ein 70B-Modell vollständig On-Premises betreiben kann.


Die Cloud-Rechnung
Sam betreibt KI-Inferenz für ein mittelständisches Post-Production-Haus. Drei Monate nach dem Produktionsstart wurde das Proof-of-Concept-Projekt, das das Team begeistert hatte, teuer. Die Cloud-Inferenz wurde kostspielig und sein Budget litt darunter.
Bei anhaltender Last wächst Ihre Rechnung schneller als Ihr Verbrauch. Jedes Mal, wenn Sam die Inferenz-Volumina erhöhte, Nutzer hinzufügte oder das Modell auf einen neuen Bereich des Pipelines ausdehnte, stapelte sich der Token-Kostenaufschlag.
Eine größere Cloud-Modellvariante war eine Option. Sam rief einen unserer Ingenieure an und stellte die Rechenleistung in den Rack-Schrank.
Das VRAM-Problem
Sams Auftrag war spezifisch: Ein 70B-Parameter-Modell, Kundendaten, die vor Ort bleiben müssen, mit GDPR-Anforderungen und zwei Rack-Einheiten Platzbedarf. Ein 70B-Modell benötigt mehr als 140GB VRAM. Eine einzelne RTX PRO 6000 Blackwell-Karte liefert 96GB. Zwei Standardkarten geben Ihnen das VRAM-Limit, während die Inter-GPU-Bandbreite für eine effiziente Inferenz über diese hinweg eine andere Konfiguration erfordert. Vier Karten in einem Chassis, das für die Wärmebelastung ausgelegt ist – die Bandbreite war die Antwort.
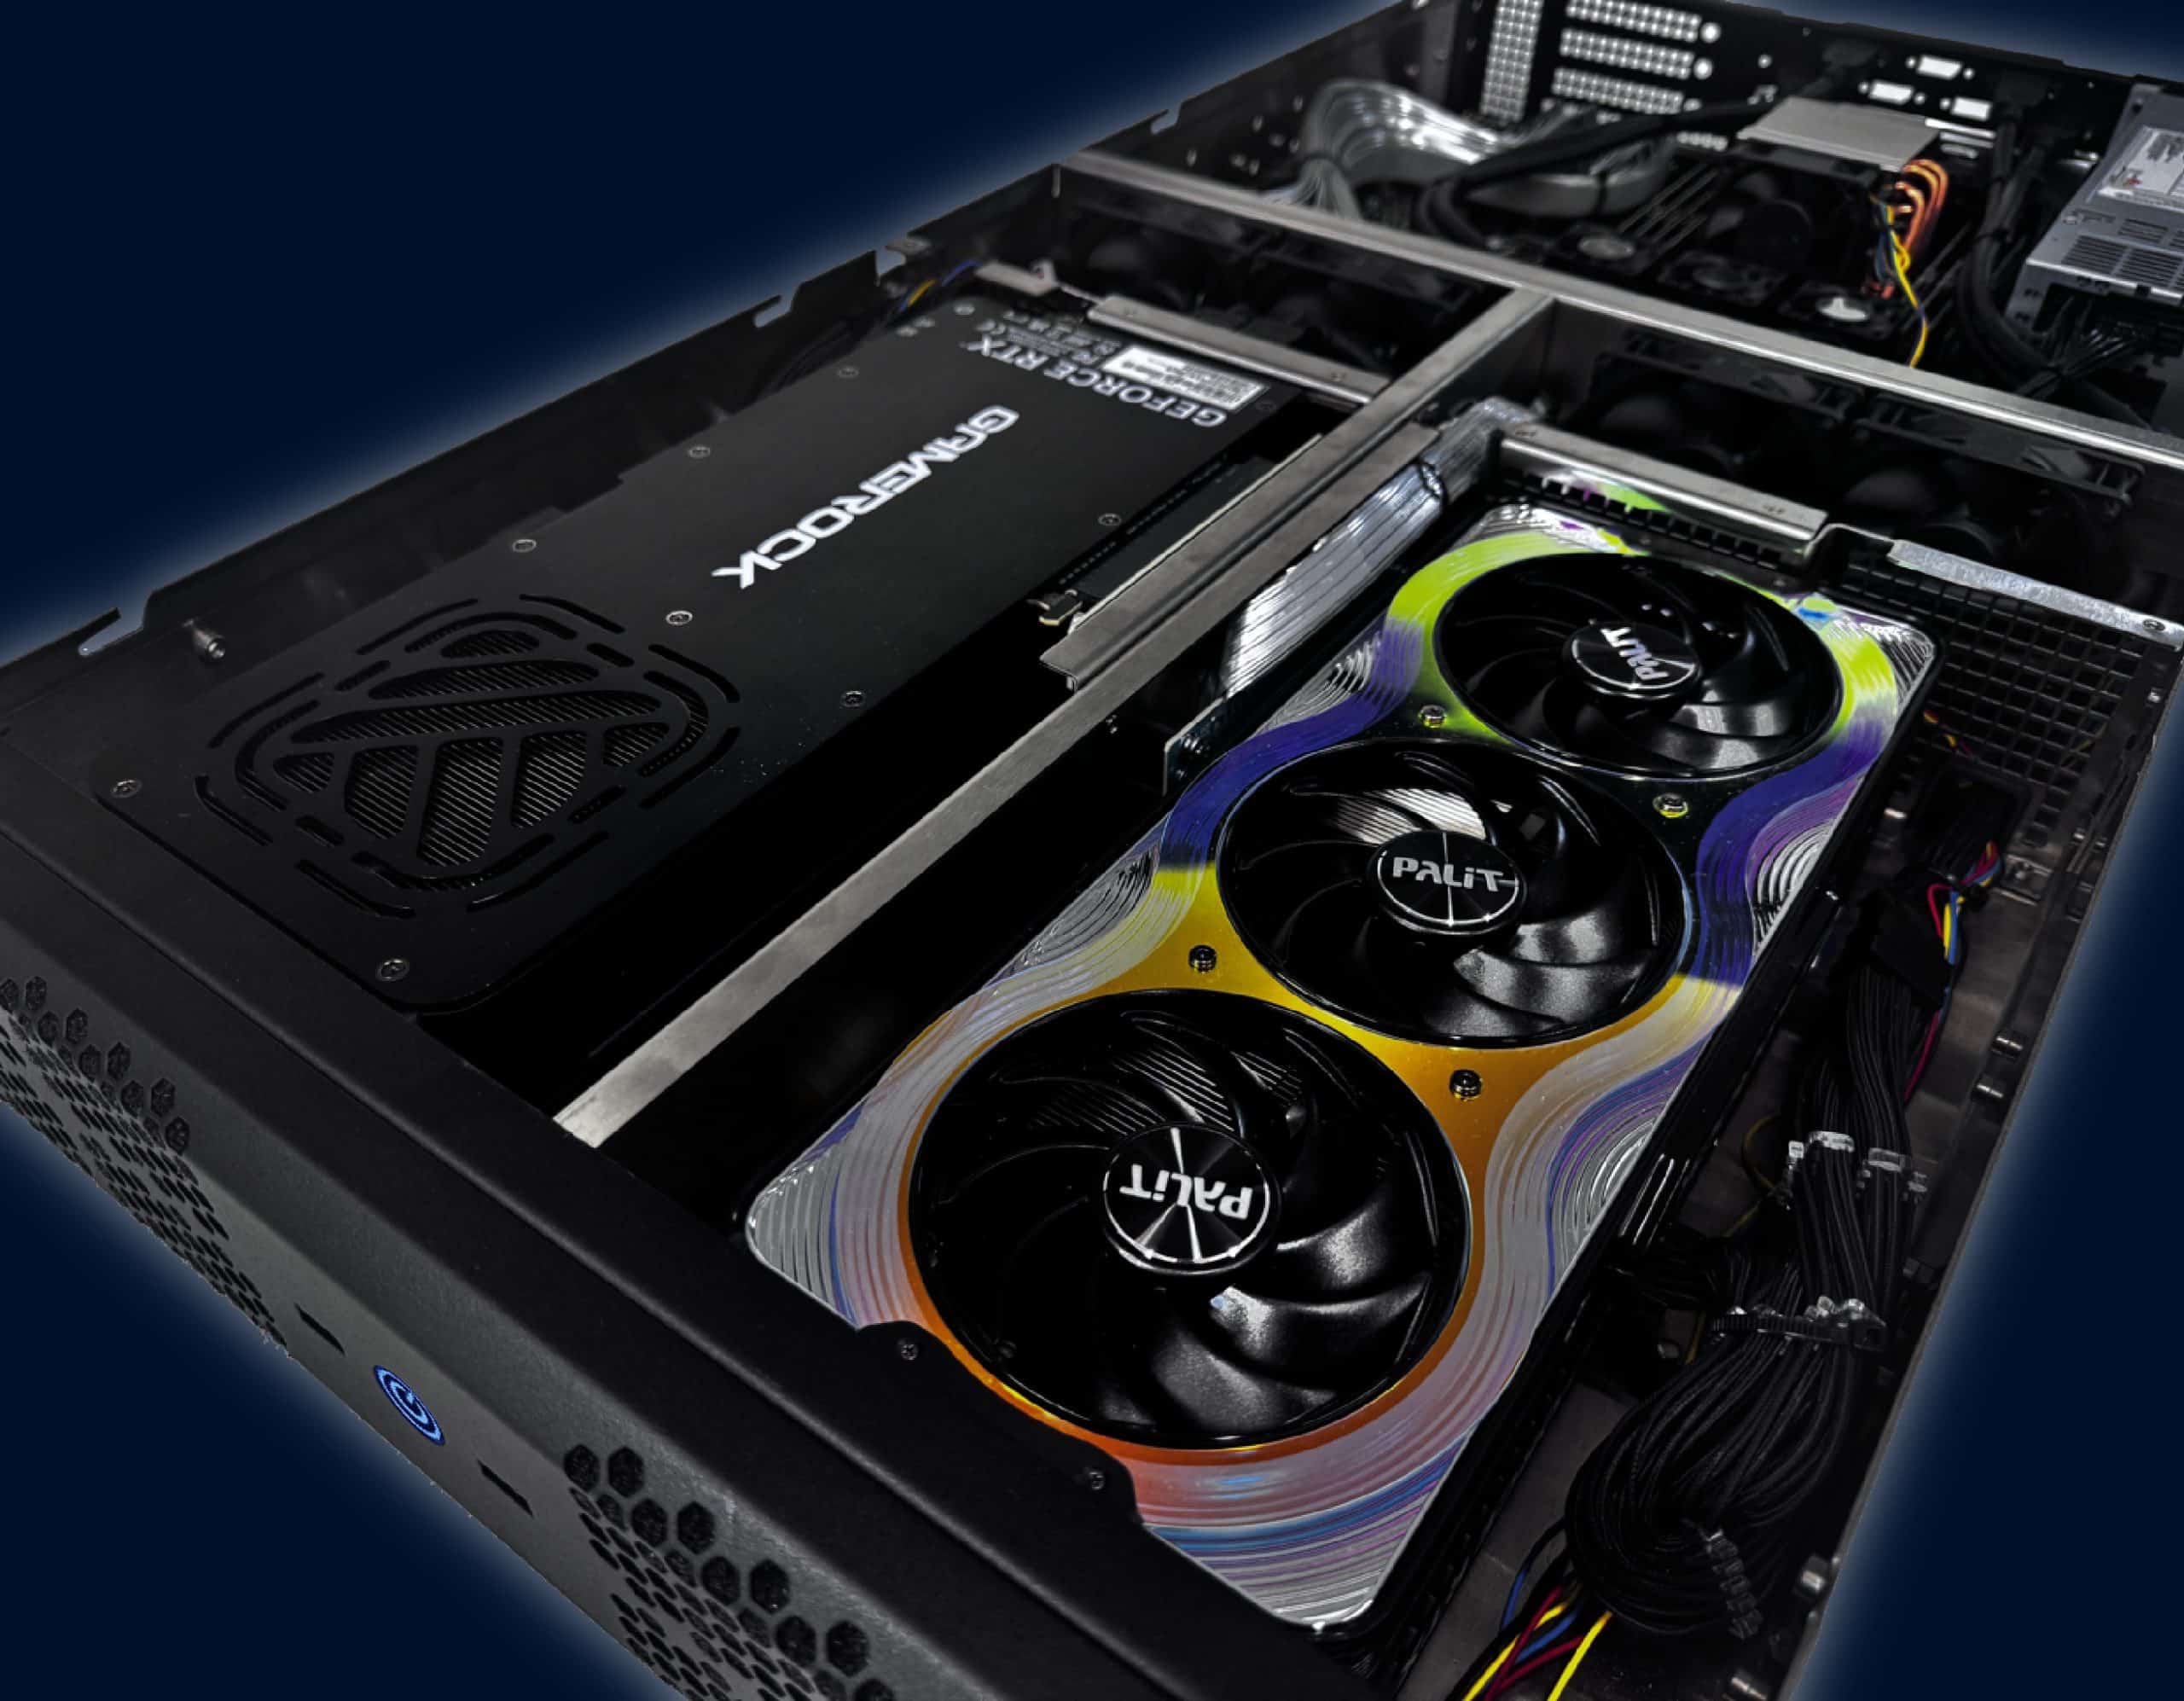
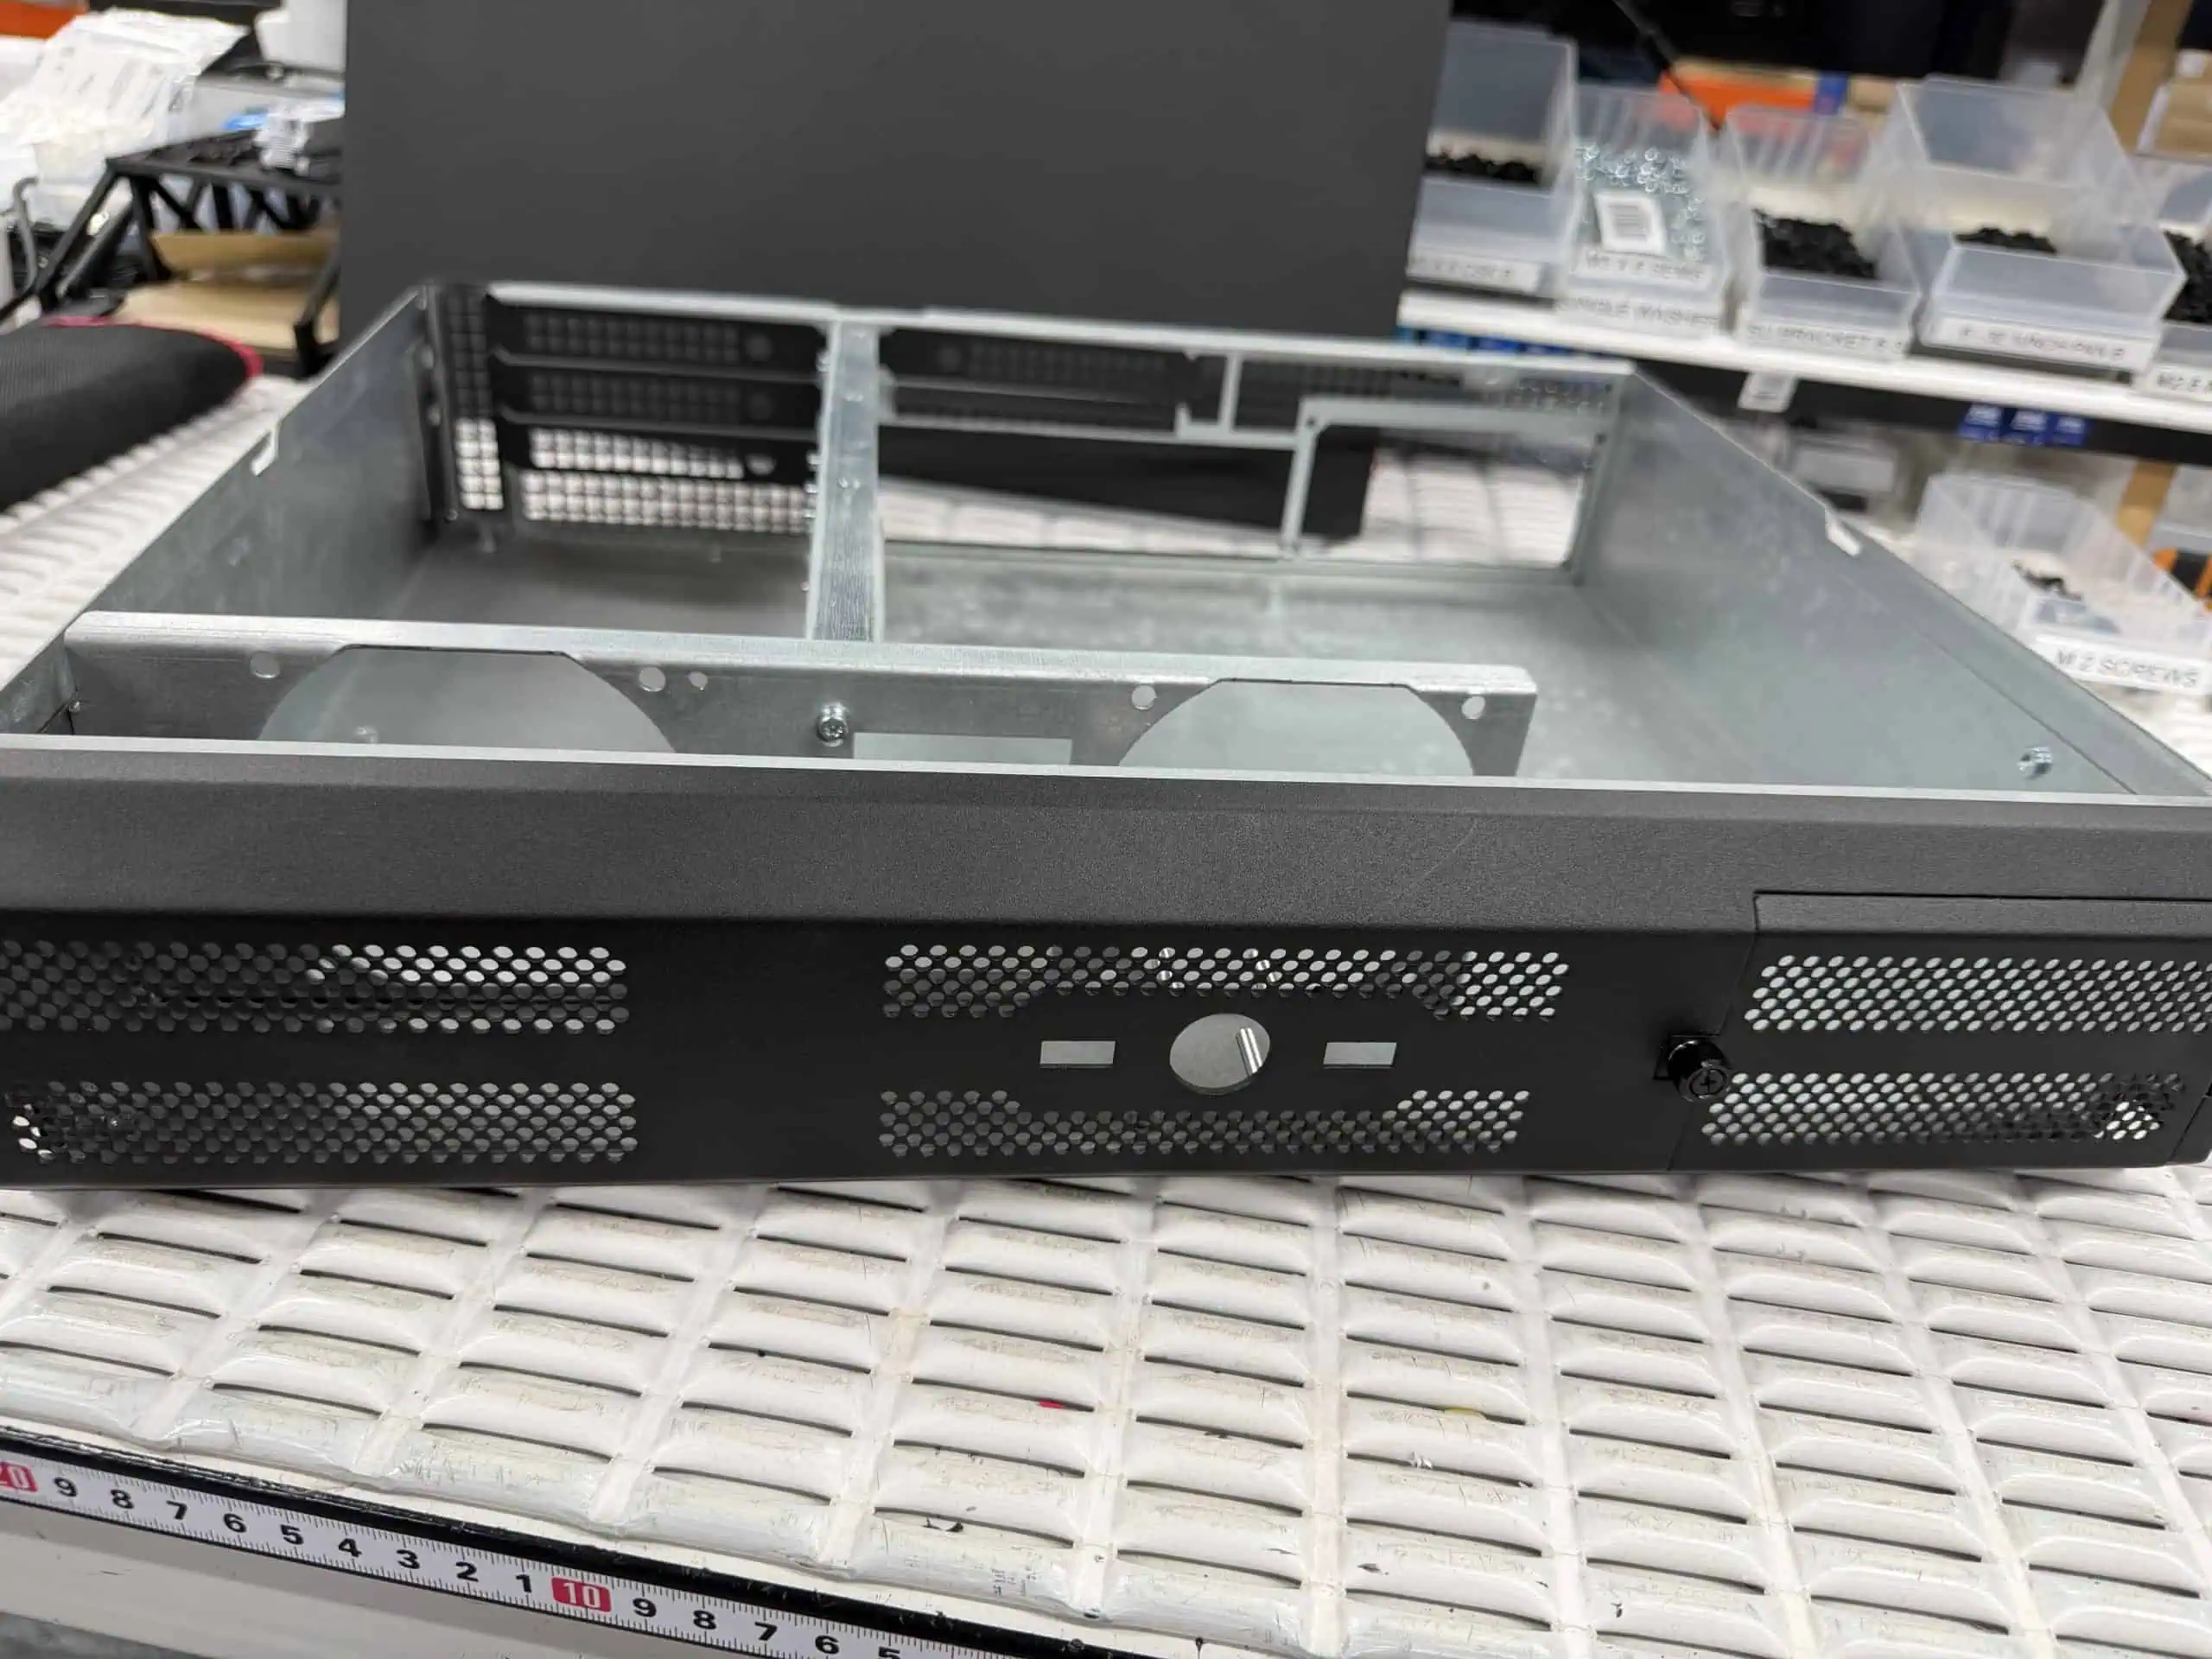
Die 2U Q-Power bringt vier RTX PRO 6000 Blackwell-Karten in ein 2U-890mm-Chassis. 384GB ECC VRAM in zwei Rack-Einheiten, genug, um Sams 70B-Modell vollständig in den VRAM zu laden und Inferenz ohne Offloading auszuführen. Das Chassis ist ausgelegt für vier Karten, die auf vollen Touren laufen. Die Q-Power ist für anhaltende Workloads konzipiert, mit Konfigurationen, die getestet werden, bevor sie Hampshire verlassen.
Sam hatte zwei Rack-Einheiten. Die 2U Q-Power füllte sie aus
Für Sams 70B-Modell-Anforderung haben wir die Quad NVIDIA RTX PRO 6000 Blackwell-Konfiguration gewählt – vier Karten, 384GB ECC VRAM, im selben 2U-890mm-Chassis. Das vollständige Modell lädt in den VRAM und Inferenz läuft mit sub-40ms Latenz, während die Daten das gesamte Netzwerk durchlaufen.
Die Auswirkung
Sams Team verlagerte die Produktions-Inferenz On-Premises. Die Kosten pro Token sanken um einen Faktor, der bedeutet, dass sich die Hardware innerhalb eines Jahres amortisieren wird.
Die Latenz fiel von 1,5 Sekunden bei einer Cloud-Rundreise auf unter 40ms vor Ort. Der Cloud-Vertrag wird weiterhin genutzt, experimentelle Workloads gehen noch dorthin. Die Arbeit, die jeden Tag läuft, Volumen verarbeitet und Kosten treibt, läuft auf Hardware von G2, die vollständig in einem Rack gebaut wurde, das Sams Team kontrolliert.
Sehen Sie sich mehr zur 2U Q-Power an oder besuchen Sie die Produktseite hier. G2 Digital baut GPU-dichte Rack-Server für Teams, die ernsthafte Workloads On-Premises betreiben. Kommen Sie mit einem teilweise definierten Spec. Gehen Sie mit einem Plan ab.
Sie mit einem Ingenieur →