Die realen Kosten von Cloud-Inferenz
Der Aufbau Ihres ersten KI-Anwendung im Cloud ist einfach. Das Skalieren ist eine andere Geschichte. Entdecken Sie, warum die Ökonomie moderner GPUs eine praktikative Alternative für Produktionslasten darstellt.


Die Token-Rechnung ist die neue Lizenzgebühr
Sie haben die Demo auf Cloud-APIs gebaut, weil die Einstiegs kosten minimal waren. Ein paar Euro, ein paar hundert API-Aufrufe, ein Modell, das Ihre Bedürfnisse unterstützte und gut aussah.
Dann kommt Ihre Rechnung an.
Unabhängige Analysen, einschließlich des Lenovo’s 2026 Generative AI TCO whitepapers und von Tilkal’s 2026 cloud versus on-premises kostenstudie, stellen Self-Hosted-Inferenz bei bis zu 18-fach günstiger pro Million Tokens als Premium-Cloud-APIs unter anhaltender Last dar.
Die Rechenleistung-Verlagerung, die bereits stattfindet
Wir sprechen regelmäßig mit Ingenieuren über das Warten auf Cloud-GPUs und Preisänderungen zwischen Planungszyklen.
Mit on-premises Hardware sitzt sie im Rack, läuft Ihre Arbeitslast und Kosten sind fest, wenn Sie kaufen.
On-premises-Infrastruktur kann Organisationen dabei helfen, Daten- und Compliance-Anforderungen einschließlich GDPR, HIPAA und SOC 2 zu erfüllen, während sensible Arbeitslasten unter ihrer eigenen Kontrolle bleiben.
Cloud-Roundtrips laufen rund um die 1,5 Sekunden unter normalen Bedingungen (BenchLM, 2026). Lokale Inferenz auf aktueller Hardware ist unter 40 Millisekunden (Software Tailor, 2026). Für Computer Vision bei Leitzahlgeschwindigkeit, Live-Übertragungsinferenz oder ROV-Videanalyse ist sub-40-Millisekunden-Antwortzeit eine funktionale Anforderung.
Warum on-premises KI stillstand und warum sich das geändert hat
Das Laufen eines ernsthaften LLM lokal erfordert ausreichend VRAM, um das gesamte Modell gleichzeitig im GPU-Speicher zu halten. Ein 70B-Parameter-Modell ist ein großer numerischer Datensatz, und wenn Ihre GPU nicht alles halten kann, tauscht das System Teile in und aus langsamerem Speicher und die Inferenzgeschwindigkeit bricht steil ab. Sie benötigen auch ausreichend Inter-GPU-Bandbreite, um Inferenz über Karten hinweg effizient zu betreiben, und ein Chassis, das Thermik bei anhaltender Last managt. Bis vor kurzem bedeutete es alle drei Dinge erheblichen Rack-Platz, und die meisten Teams betrieben ihre Produktions-KI in der Cloud.
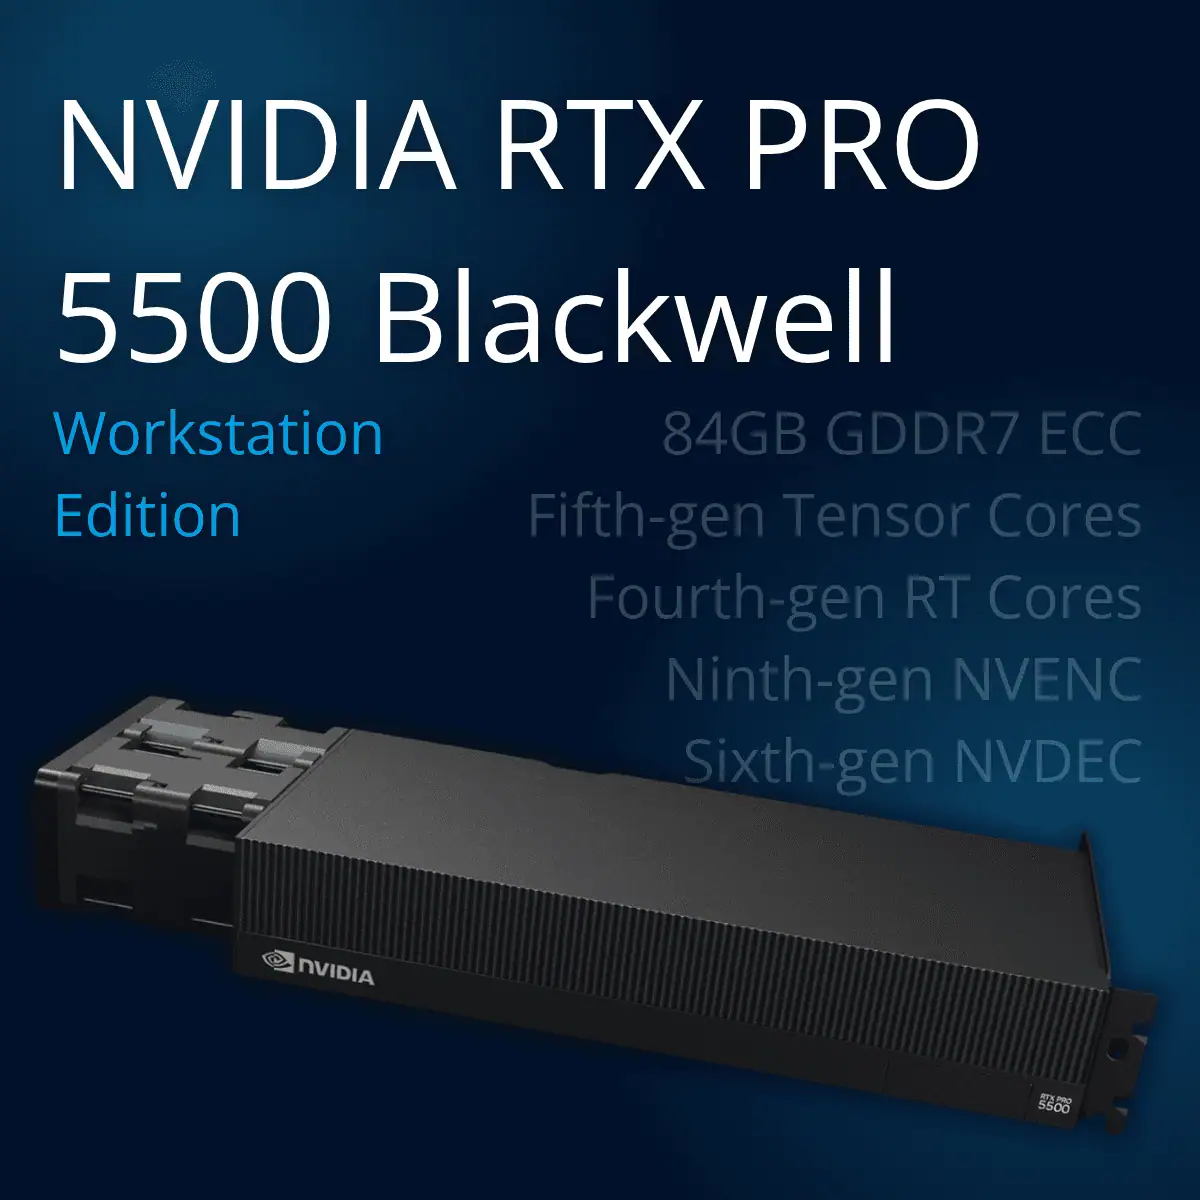
Ein 70B-Parameter-Modell braucht nördlich von 140GB VRAM, und eine einzelne Karte erreicht maximal 96GB. Zwei Standardkarten erreichen das Speicher-Grenzwert und fehlen die Inter-GPU-Bandbreite, um Inferenz darüber hinweg richtig zu betreiben.
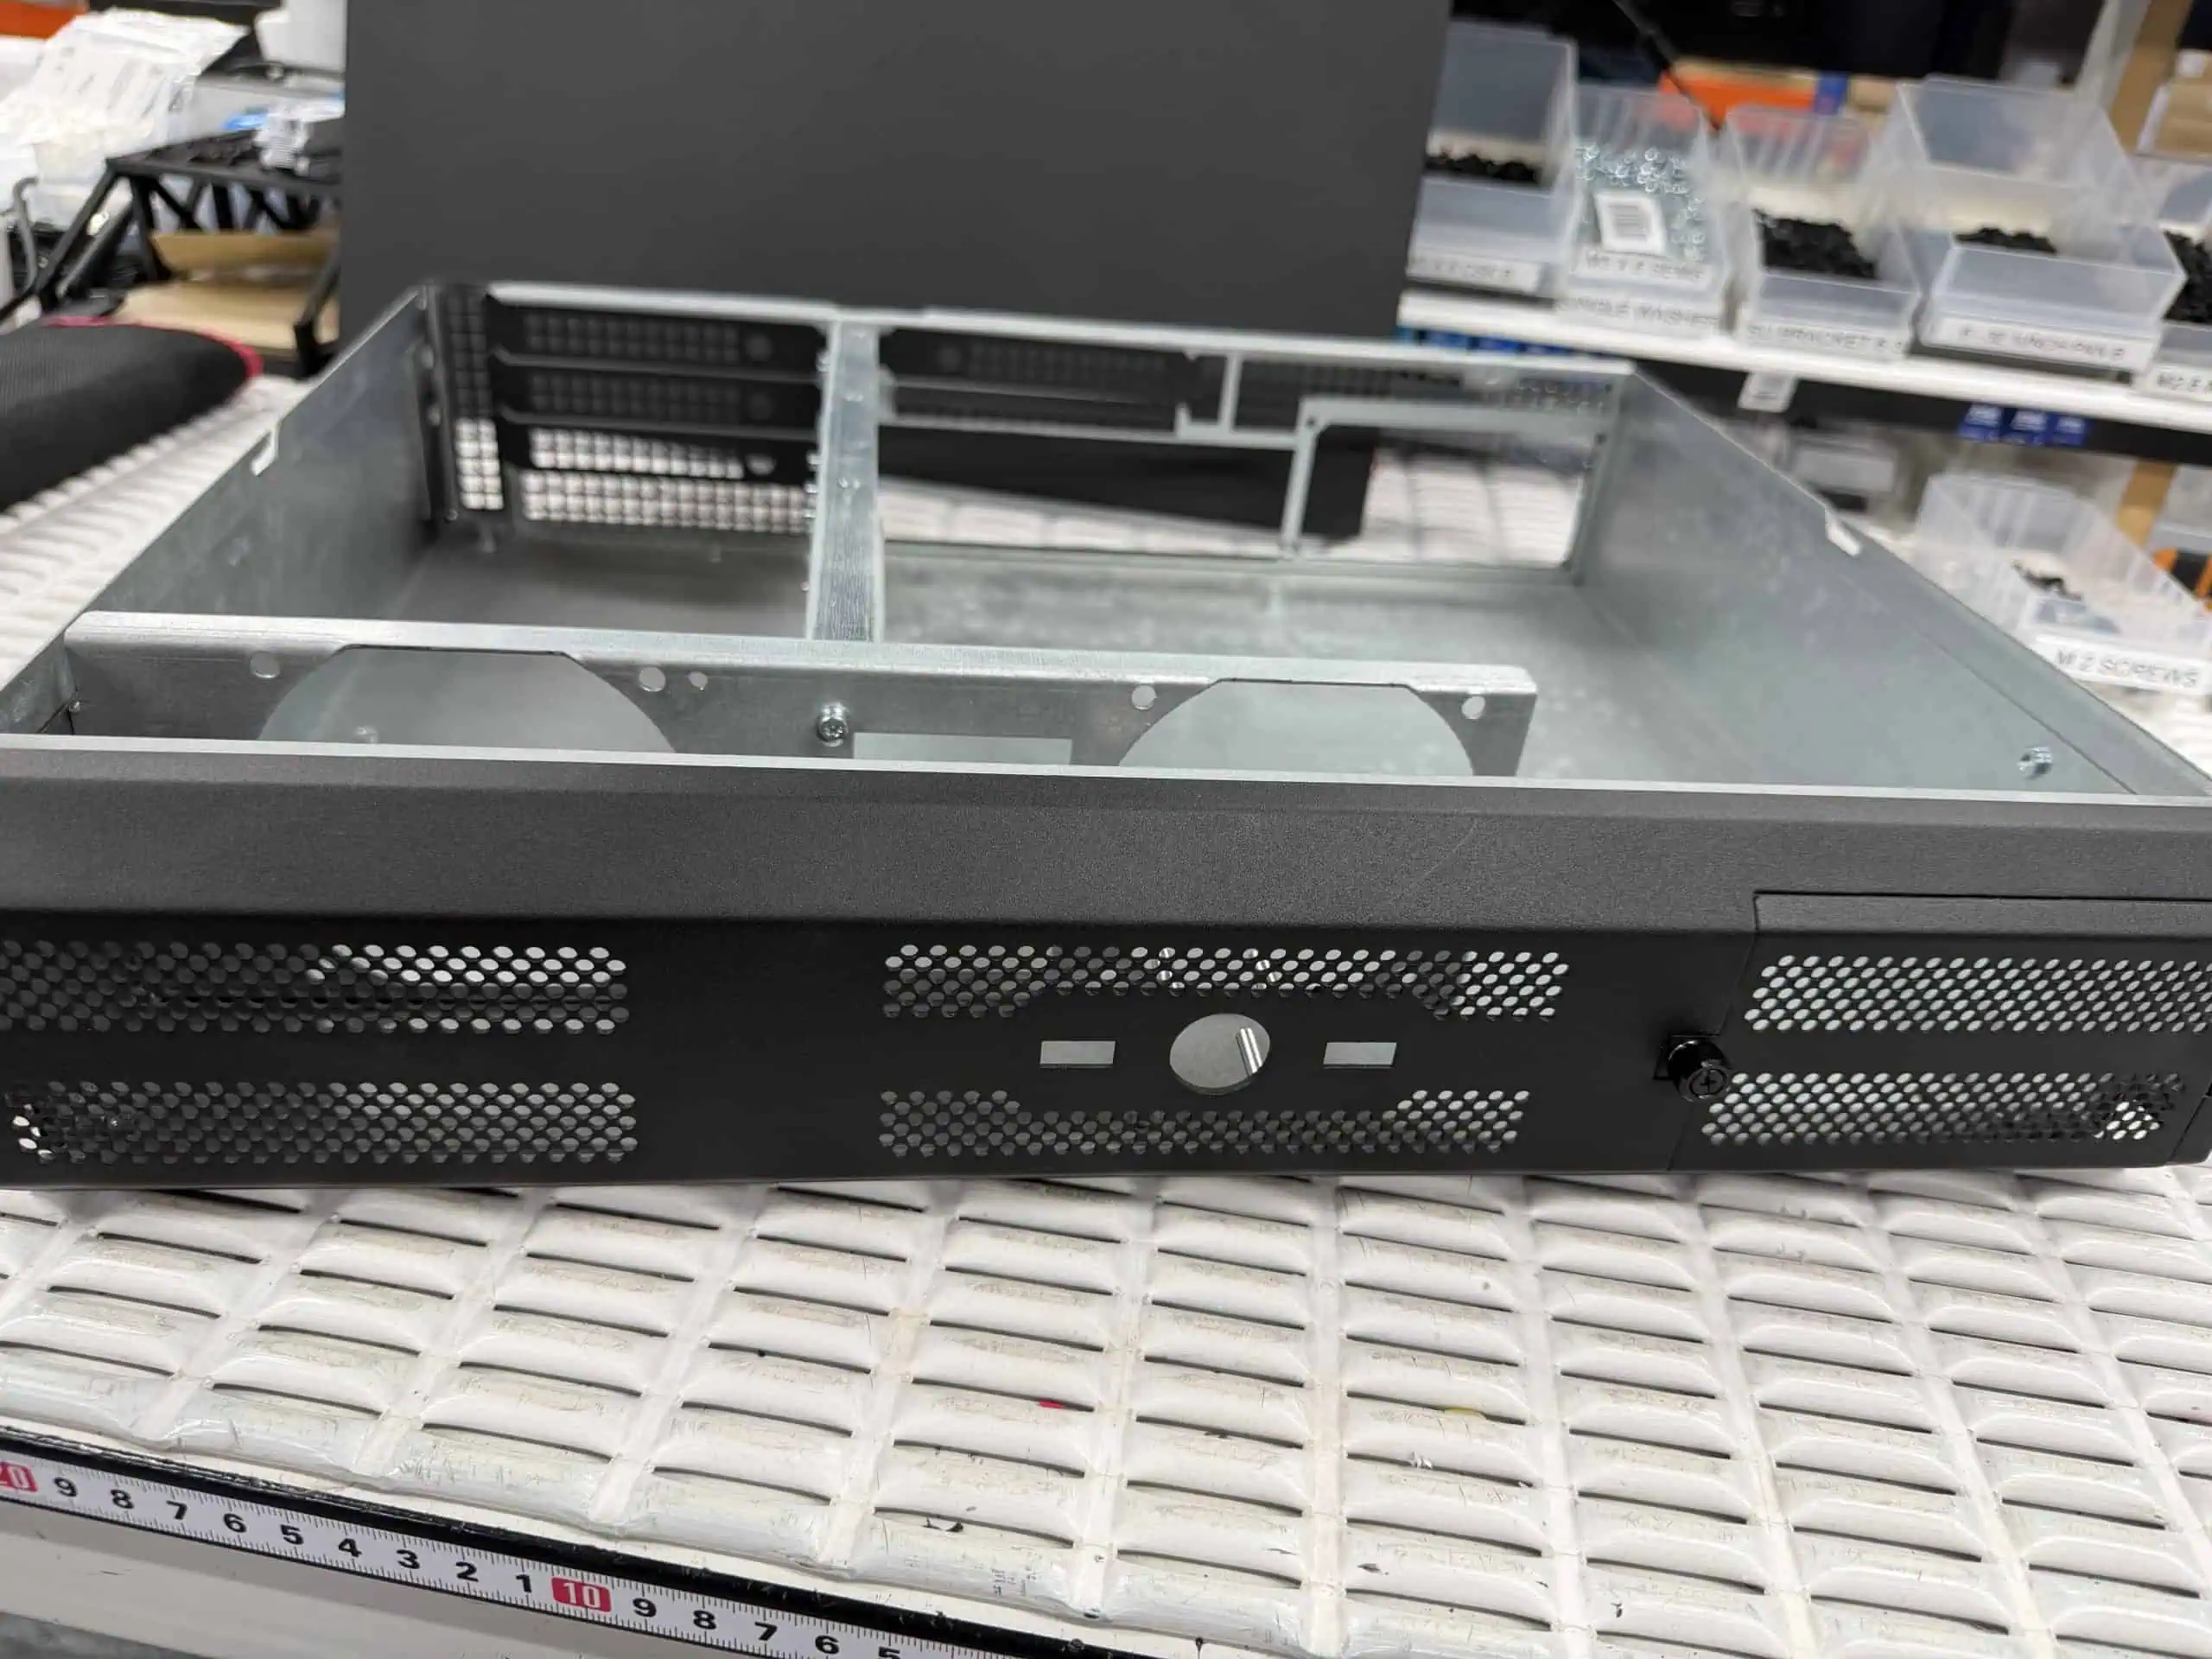
Die passen jetzt in ein 2U. Zwei NVIDIA RTX 5090 liefern 64GB GDDR7 GPU-Speicher in einem 2U-chassis, das für anhaltende GPU-Arbeitslasten entwickelt und getestet wurde. Ein 70B-Parameter-Modell braucht nördlich von 140GB VRAM, was es über die Kapazität einer einzelnen 96GB-GPU hinaus stellt. Multi-GPU-Konfigurationen lösen die Speicheranforderung, bringen aber auch Herausforderungen rund um GPU-zu-GPU-Kommunikation, Stromversorgung, Kühlung und Rack-Dichte mit sich.
Die Entscheidung wird einfacher
Vor einem Jahr benötigte die on-premises-versus-cloud-Entscheidung eine Excel-Tabelle voller Annahmen. Arbeitslastwachstum, Hardware-Langlebigkeit, fünfjährige TCO. Diese Annahmen werden zu Daten. Der Schnittpunkt, wo besitzene Hardware günstiger wird als äquivalente Cloud-Ausgaben, kommt früher als die Finanzen projiziert und bei niedrigeren Volumina als das Engineering erwartet hat.
Cloud macht Sinn für sprunghafte Arbeitslasten, Experimente und dort, wo das Volumen unvorhersehbar ist. Für Produktions-KI mit konsistenten Arbeitslasten, sensiblen Daten und Echtzeitanforderungen kann die Ökonomie des Hardware-Besitzes sehr anders aussehen als die Ökonomie jedes Inferenzlaufs durch eine Cloud-API zu laufen.
Produktions-KI in der Cloud betreiben und Tokenkosten steigen beobachten? Lesen Sie, wie ein Post-Production-Team sein 70B-Modell on-premises verlegt, Latenz um 97% gesenkt hat und die Hardware auf sub-12-monatige Amortisierung gebracht hat → The Cloud Bill: Sam’s Story
Mehr über das 2U Q-Power, ansehen oder die Produktseite hier ansehen.
Welche Spezifikation benötigen Sie? Kontaktieren Sie uns